Reliability Friday 02: Kubernetes Readiness Probe Nasıl Doğrulanır?
Bir pod Running görünebilir ama trafik almaya hazır olmayabilir. Readiness ile liveness'ı aynı uca bağlamak neden tüm filoyu aynı anda yeniden başlatır?
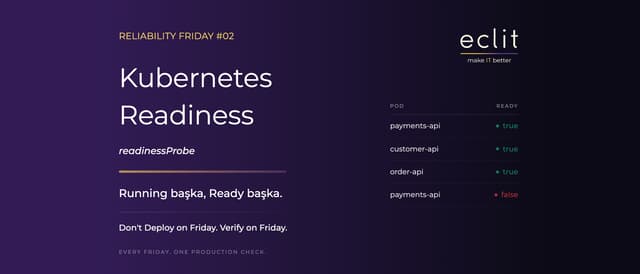
Kısa cevap: Running bir durum, Ready bir taahhüt. Bir pod'un Running görünmesi, uygulamanın gerçekten kullanıcı trafiği almaya hazır olduğu anlamına gelmez. Aradaki farkı readinessProbe kurar; tanımlı değilse Kubernetes uygulama katmanında hazır olup olmadığını doğrulayamaz ve hazır olmayan pod'a trafik gönderir. Probe'u eklemek kolay kısmı; asıl hata readiness ile liveness'ı aynı uca bağlamakta.
Don't Deploy on Friday. Verify on Friday.
Bu haftanın kontrolü
Pod'ların gerçek readiness durumunu görmek için:
kubectl get pods -A \
  -o custom-columns='NAMESPACE:.metadata.namespace,POD:.metadata.name,READY:.status.containerStatuses[*].ready,RESTARTS:.status.containerStatuses[*].restartCount'
Beklenen çıktı
Sağlıklı görünen bir tablo:
payments-api     true    0
customer-api     true    0
order-api        true    0
Araştırılması gereken satır:
payments-api false 14false her zaman problem değildir; yeni başlayan bir pod geçici olarak hazır olmayabilir. Ancak uzun süre false kalan pod araştırılmalıdır. Yanındaki yeniden başlatma sayacı da ikinci bir hikâye anlatır: sürekli artan bir sayaç, aşağıdaki hataya işaret eder.
En pahalı hata: iki probe'un aynı uca bağlanması
readinessProbe ile livenessProbe farklı sorular sorar ve Kubernetes belgeleri bu ayrımı açıkça çizer:
- Readiness: "Şu anda istek alabilir miyim?" Cevap hayırsa pod Service trafiğinden çıkarılır ve beklemeye alınır.Liveness: "Bu süreç kurtarılamaz durumda mı?" Cevap evetse container öldürülüp yeniden başlatılır.
Aynı /health ucunu ikisine birden vermek en yaygın kurulum hatası. O uç, readiness için doğru olan şeyi yapar ve veritabanını yoklar. Veritabanı düştüğünde liveness da başarısız olur; kubelet container'ı öldürür. Bağlantıyı aynı anda tüm pod'lar kaybettiği için tüm filo aynı saniyede yeniden başlar. Veritabanı geri geldiğinde karşısında hep birlikte açılan bir bağlantı dalgası bulur.
Kural şu: liveness dış bağımlılığa bakmaz. Yalnızca sürecin kendi içinde kilitlenip kilitlenmediğini sorar. Bağımlılık kontrolü readiness'ın işidir.
İki uç ayrılmalı:
readinessProbe:
  httpGet:
    path: /ready          # veritabanı, kuyruk, önbellek yoklanır
    port: 8080
  periodSeconds: 5
  timeoutSeconds: 2
  failureThreshold: 3

livenessProbe:
  httpGet:
    path: /live           # yalnızca süreç içi durum
    port: 8080
  periodSeconds: 10
  failureThreshold: 3
İkinci tuzak: çok hassas failureThreshold
failureThreshold: 1 mantıklı görünür ama gecikmesi değişken bir bağımlılığı yokladığında pod'lar tek bir yavaş yanıtta endpoint listesinden düşer. Trafik kalan pod'lara yığılır, onların da yanıt süresi uzar, onlar da düşer. Kimse çökmeden yaşanan bir kesinti tablosu ortaya çıkar.
Yavaş açılan uygulamalarda initialDelaySeconds büyütmek yerine startupProbe kullanın: açılış boyunca diğer iki probe'u susturur, açılış bitince devreye girerler.
Service gerçekten hangi pod'lara trafik gönderiyor?
kubectl get endpointslices \
  -l kubernetes.io/service-name=<service-name>
Ready olmayan pod'ların Service trafiğine dahil edilmemesi gerekir. Bu komut, probe'un beyan ettiği durumun trafik yönlendirmesine gerçekten yansıyıp yansımadığını gösterir; ikisi arasındaki uyuşmazlık, sorunun probe'da değil Service tanımında olduğunu söyler.
Neden önemli
Eksik ya da yanlış kurgulanmış readiness kontrolü şunlara yol açar:
- uygulamanın initialization tamamlanmadan trafik alması,bağımlılıklar hazır olmadan istek kabul edilmesi,rolling update sırasında 5xx ve timeout oluşması,deployment başarılı görünürken kullanıcı deneyiminin bozulması.
Sonuncusu en sinsi olanı. Deployment yeşil, pod'lar Running, gösterge panelinde her şey normal, ama kullanıcı hata alıyor. Bu tablonun ortaya çıktığı yer neredeyse her zaman eksik ya da yanlış bağlanmış bir readiness probe'dur. Kubernetes bu iki durumu ayırt etmek için sizin verdiğiniz sinyale ihtiyaç duyar.
Otomatikleştirin
Bugün kontrol edin, yarın otomatikleştirin. kube-score, Polaris ya da policy-as-code kontrollerini CI/CD hattına ekleyerek readiness probe eksiklerini production'a ulaşmadan yakalayabilirsiniz. Kuralı yazarken yalnızca "probe var mı" diye sormayın; readiness ile liveness yollarının farklı olduğunu da kontrol edin, çünkü asıl arıza orada.
Detect → Understand → Automate. Haftalık elle kontrol, otomasyon kurulana kadar fayda sağlar; nihai çözüm değildir. Aynı yaklaşımı geçen hafta PostgreSQL replication lag için de izlemiştik.
Eclit notu
Devraldığımız cluster'larda en sık gördüğümüz iki satır, aynı /health yolunu paylaşan readiness ve liveness tanımları. İkisini ayırmak beş dakikalık iş ve bir veritabanı kesintisini filo çapında yeniden başlatmaya çevirmenin önündeki tek engel.
Container platformlarının işletilmesi ve bu tür kontrollerin operasyona yerleştirilmesi bulut yerel platform hizmetlerimizin kapsamındadır.
Every Friday. One Production Check.