Reliability Friday 01: PostgreSQL Replication Lag Nasıl Ölçülür?
Replica ayakta olabilir ama ne kadar geride? pg_stat_replication ile gecikmeyi ölçmek, sıfır satırın neden sıfır gecikme demek olmadığı ve eşiği RPO'dan türetmek.
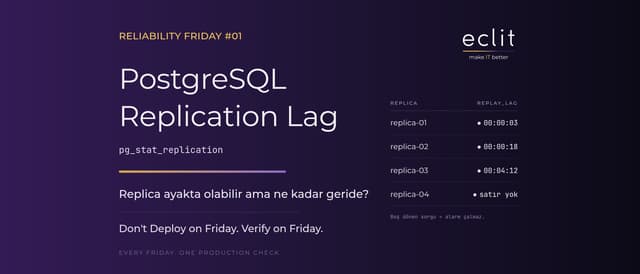
Kısa cevap: Replica'nın ayakta olması yeterli değil. Primary üzerinde çalıştırılan pg_stat_replication görünümü, her replica'nın ne kadar geride olduğunu üç ayrı aşamada gösterir. Eşik RPO hedefinizden türetilir; 30 saniyenin altı normal, 5 dakikanın üstü ya da sürekli artan gecikme alarm konusudur. Asıl tehlikeli durum ise büyük bir sayı değil, hiç satır dönmemesi.
Don't Deploy on Friday. Verify on Friday.
Bu haftanın kontrolü
Primary ile replica arasındaki gecikmeyi görmek için, sorguyu primary üzerinde çalıştırın:
SELECT
  application_name,
  client_addr,
  state,
  sync_state,
  write_lag,
  flush_lag,
  replay_lag,
  pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_bytes
FROM pg_stat_replication
ORDER BY replay_lag DESC NULLS LAST;
Beklenen çıktı
Sorgu her replica için bir satır döner. Örneğin replay_lag: 00:04:12 çıktısı, replica'nın primary'nin yaklaşık 4 dakika 12 saniye gerisinde olduğu anlamına gelir.
Üç sütun üç farklı aşamayı ölçer: write_lag verinin replica'ya ulaşmasını, flush_lag diske yazılmasını, replay_lag uygulanmasını. Aralarındaki fark darboğazın nerede olduğunu söyler. write_lag düşük ama replay_lag yüksekse sorun ağda değil, replica'nın WAL'ı uygulama hızındadır; bu genelde tek bir uzun sorgunun uygulamayı bloke etmesinden ya da disk IO'sundan kaynaklanır.
Son sütun aynı mesafeyi bayt olarak verir. Süre insan için, bayt alarm eşiği için daha güvenilir bir ölçüdür: yazma trafiği düşükken saniye cinsinden gecikme küçük görünse de birikmiş WAL büyük olabilir.
Sıfır satır, sıfır gecikme değildir
pg_stat_replication her WAL gönderici süreç için bir satır tutar. Replica bağlantısını kaybettiğinde o süreç sonlanır ve satır tablodan tamamen kaybolur.
Bunun sonucu şu: replay_lag > 5 dakika koşuluna kurulmuş bir alarm, replica düştüğünde asla tetiklenmez. Karşılaştıracağı satır yoktur, sorgu sessizce boş döner ve nöbet ekranı yeşil kalır. Bu yüzden asıl kontrol gecikme değil sayımdır:
SELECT count(*) FROM pg_stat_replication WHERE state = 'streaming';Beklenen replica sayısını bir yere yazın ve alarmı bu sayının altına düşmeye kurun. Gecikme alarmı ikinci sıradadır.
Ne zaman aksiyon alınmalı?
Sabit bir doğru eşik yok; RPO hedefinizden türetilir. Genel referans:
30 saniyenin altı: normal, izlemeye devam.
30 saniye ile 5 dakika arası: nedeni araştırın; yazma yükü, checkpoint sıklığı ya da ağ darboğazı.
5 dakikanın üstü veya sürekli artıyor: failover ve raporlama kararlarını gözden geçirin, alarm tetiklenmeli.
Boştaki primary yanlış alarm üretir
Replica tarafında sık kullanılan ikinci yöntem now() - pg_last_xact_replay_timestamp(). Kullanışlı, ama bir tuzağı var: bu fonksiyon son uygulanan işlemin zaman damgasını döner. Primary hiç commit üretmiyorsa, örneğin gece ya da hafta sonu, uygulanacak yeni bir işlem olmadığı için bu fark durmadan büyür. Replikasyon kusursuz çalışırken alarm çalar.
İki ölçüyü birlikte kullanın: pg_stat_replication primary'nin gerçekte ne kadar ileride olduğunu bilir, pg_last_xact_replay_timestamp() bilmez.
Risk
Yoğun yazma trafiği, ağ darboğazı ya da sık checkpoint'ler gecikmeyi artırır. Gecikme büyüdüğünde replica çalışıyor görünse bile güncel veriden uzaklaşır. Bunun üç sonucu olur: failover sırasında veri kaybı, raporlarda eski veri, ve SLA ihlali.
En sinsi olanı ikincisi. Raporlama yükünü replica'ya taşımak yaygın bir pratiktir ve doğrudur, ama gecikme izlenmiyorsa iş birimi farkında olmadan dünün verisine bakıyor olabilir. Bu, kimsenin olay kaydı açmadığı türden bir arızadır.
Otomatikleştirin
Bu sorguyu her cuma elle çalıştırmak yerine, Prometheus postgres_exporter ile pg_replication_lag metriğini toplayıp Grafana'da eşik bazlı alarm kurabilirsiniz. Kurarken iki kuralı birlikte yazın: gecikme eşiği ve replica sayısı eşiği. Yalnız birincisini kuran ekiplerin düşen replica'yı günler sonra fark ettiğini görüyoruz. Alarmların neden geç haber verdiğini Prometheus'u herkes kurdu yazısında ayrıca ele aldık.
Haftalık manuel kontrol, otomasyon kurulana kadar fayda sağlar; nihai çözüm değildir.
Eclit notu
Replikasyon izlemede en sık gördüğümüz hata, tek bir metriğe bakmak. Gecikme süresi, bayt farkı ve bağlı replica sayısı üç farklı arızayı yakalar ve biri diğerinin yerine geçmez. Üçünü birden kurmak on dakikalık iş; veritabanı platform mühendisliği tarafında standart olarak bu üçlüyle başlıyoruz.
Bu yazı ilk olarak Eclit Engineering Medium hesabında yayımlandı.