AI Stack Tasarımı ve Mühendisliği
Kurumsal yapay zekâ altyapısının tasarımı ve kurulumu. GPU kapasitesi, model serving katmanı, vektör veritabanı ve data residency kısıtlarının mimariye baştan yazılması.
Neler sunuyoruz
Eğitim ve inference iş yüklerinin ayrı profillerine göre kapasite planlaması; güç, soğutma ve node'lar arası bant genişliğinin donanım alınmadan önce hesaplanması.
Modellerin üretimde çalıştırılması için model serving altyapısı: sürümleme, ölçekleme, gecikme hedefleri ve geri dönüş yolunun tanımlı olması.
Vektör veritabanı seçimi ve kurulumu, embedding pipeline'ı ve veri hazırlama akışlarının tekrarlanabilir biçimde tasarlanması.
Kişisel ve düzenlemeye tabi verinin yerel kalması, hassas olmayan iş yüklerinin dışarıda çalışabilmesi. Ayrım baştan kurulur; sonradan ayırmak çok daha pahalıdır.
Birden fazla ekibin aynı GPU kaynağını kullandığı durumda kota, öncelik ve kuyruk politikası. Bu katman yoksa en gürültülü ekip kaynağı sahiplenir.
GPU kullanım oranının ölçülmesi ve ekip bazında raporlanması. Sahiplik ya da kiralama kararı bu veriyle alınır, tahminle değil.
Nasıl çalışıyor
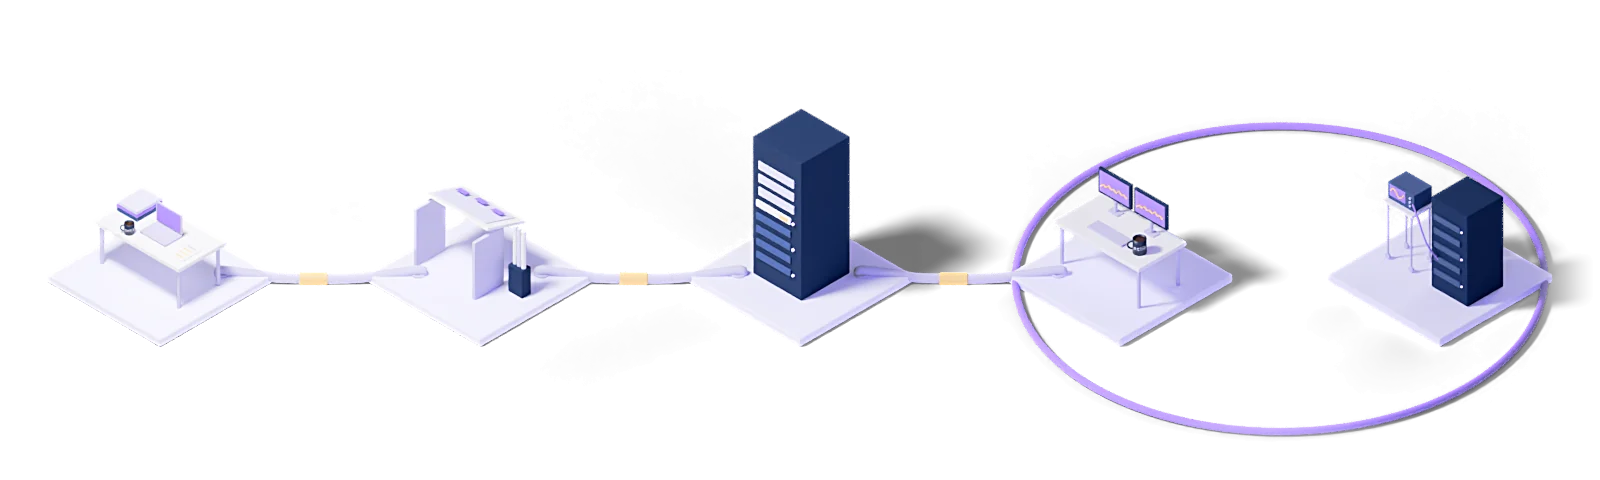
Her iş aynı beş adımdan geçer: mevcut durumu çıkarırız, hedef modeli tasarlarız, kademeli devreye alırız, işletiriz ve ölçüme göre iyileştiririz.
Tespit
Mevcut durumu çıkarır, açıkları ve başarı ölçütlerini yazılı hale getiririz.
Tasarım
Hedef işletim modelini ve gereken araç zincirini kurgularız.
Devreye alma
Kademeli olarak kurar, yapılandırır ve doğrularız.
İşletim
7/24 yönetim; sözleşmeli müdahale süreleri ve önleyici izleme.
İyileştirme
Metrikler, olaylar ve iş ihtiyacındaki değişime göre sürekli iyileştirme.
Her iş, yazılı SLA ile yürür; iyi niyet beyanı değil, taahhüt.
Sizin stack'inizi bilen adanmış mühendisler. Genel amaçlı bir çağrı merkezi katmanı yok.
İki haftada bir servis değerlendirmesi, üç ayda bir yol haritası güncellemesi.
Bu hizmette kullandığımız teknolojiler
Bu hizmetin kavramları
- Derin öğrenme (deep learning)
- Çok katmanlı yapay sinir ağlarıyla büyük veri kümelerinden örüntü öğrenen makine öğrenmesi dalı.
- LLM (Büyük Dil Modeli)
- Çok büyük metin kümeleriyle eğitilmiş, dili anlayıp üretebilen yapay zekâ modeli.
- Machine Learning (Makine öğrenmesi)
- Açıkça programlanmak yerine veriden öğrenerek tahmin ve sınıflandırma yapan yöntemler bütünü.
- Yapay zekâ (AI)
- İnsan zekâsına özgü sayılan görevleri yerine getirebilen sistemler.
Bu sayfada geçen teknik terimlerin ne anlama geldiğini burada bulabilirsiniz. Tanımlar Eclit'in kendi teknoloji sözlüğünden alınmıştır; her terim, sözlükteki tam açıklamasına bağlanır.
Teknoloji sözlüğünün tamamı →Bilgi Merkezi
Teknoloji operasyonları ve yönetimi üzerine yazdıklarımızı burada topladık.
LLM (Büyük Dil Modeli) Nedir, Nasıl Çalışır?
6 dk okumaGPU Nedir? CPU ile Farkı ve Yapay Zekâdaki Rolü
6 dk okumaTürkiye'de Kurumsal Yapay Zekâ: Bugünkü Etki ve 2030 Ufku
6 dk okumaEgemen Yapay Zekâyı Herkes İstiyor, %29'u Yapıyor: Aradaki Fark Nerede?
2 dk okumaYapay Zekâ Altyapısı: GPU Satın Almak mı, Kiralamak mı?
4 dk okumaKVKK ve Veri Yurt Dışına Aktarım: Bulut Kullanırken Nelere Dikkat Edilmeli?
4 dk okumaYapay Zekâ Yönetişimi: Türk Şirketleri İçin Uyum Yol Haritası
5 dk okumaYapay Zeka Projeleri Neden Tıkanıyor? Cevap Veri Altyapısında
5 dk okumaYapay Zekâ (AI) Nedir? Nasıl Çalışır, Türleri ve Örnekleri
8 dk okumaMakine Öğrenmesi Nedir? Derin Öğrenme ve Yapay Sinir Ağları
7 dk okumaAI Agent Nedir? Agentic AI ve Yapay Zekâ Ajanları
8 dk okuman8n Nedir? Ne İşe Yarar, Kurulum Seçenekleri ve Lisansı
5 dk okumaOCR Nedir? Nasıl Çalışır, Kullanım Alanları ve Sınırları
5 dk okumaMCP (Model Context Protocol) Nedir? MCP Server ve Güvenliği
7 dk okumaRAG (Retrieval-Augmented Generation) Nedir? Nasıl Çalışır?
8 dk okumaMLOps Nedir? Makine Öğrenmesi Modelleri Nasıl İşletilir?
7 dk okumaVeri Zehirlenmesi (Data Poisoning) Nedir, Nasıl Önlenir?
8 dk okumaISO/IEC 42001 Nedir? Yapay Zekâ Yönetim Sistemi (AIMS)
7 dk okuma01Kendi yapay zekâ altyapımızı mı kurmalıyız, hazır servis mi kullanmalıyız?
Veri hassasiyeti ve hacim belirliyor. Kurum içinde kalması gereken veriyle çalışıyorsanız kendi altyapınız gerekiyor; genel veriyle düşük hacimde çalışıyorsanız hazır servis çok daha ucuz. İkisinin bir arada kullanıldığı yapılar da yaygın.
02GPU altyapısı kurmak mantıklı mı?
Kullanım oranı belirliyor. Sürekli çalışan eğitim ya da inference yükü varsa kendi GPU'nuz bir yıl içinde kendini amorti edebiliyor; ara sıra çalışan yüklerde bulut kiralama daha ucuz. Kullanım profilini önce ölçüyoruz.
03Verimiz modelin eğitiminde kullanılır mı?
Kendi altyapınızda hayır. Hazır servislerde sağlayıcının sözleşmesine bağlı ve bu madde ayrıca kontrol ediliyor; kurumsal katmanların çoğu eğitim dışı bırakıyor ama varsayılan davranış her sağlayıcıda aynı değil.
04Retrieval-Augmented Generation (RAG) kurulumu ne gerektiriyor?
Belge kaynağı, parçalama ve embedding pipeline'ı, vektör veritabanı ve erişim kontrolü. Sonuncusu en sık atlanan: kullanıcının göremeyeceği belgeden cevap üreten bir sistem, yetki kontrolünü baypas etmiş oluyor.
05Maliyeti nasıl kontrol altında tutuyoruz?
Token kullanımı izleniyor ve ekip ya da uygulama bazında raporlanıyor. Caching, model boyutu seçimi ve prompt uzunluğu optimizasyonu maliyetin büyük kısmını belirliyor; ölçülmeyen bir yapay zekâ harcaması hızla kontrolden çıkıyor.
Nereden başlayacağınızı birlikte çıkaralım
İki hafta içinde neyin çalıştığını, neyin risk taşıdığını ve önceliklendirilmiş bir yol haritasını yazılı veriyoruz.
Görüşme talep edin